 Code0
很多企业都有类似感受:模型能力升级了,API 单价看起来也更友好,月度账单却没有明显下降。问题往往不在“模型太贵”,而在业务没有按合格任务核算成本。上下文越塞越长、Agent 循环次数增加、失败请求重复发送、所有任务都走高阶模型,都会把单价优势吃掉。
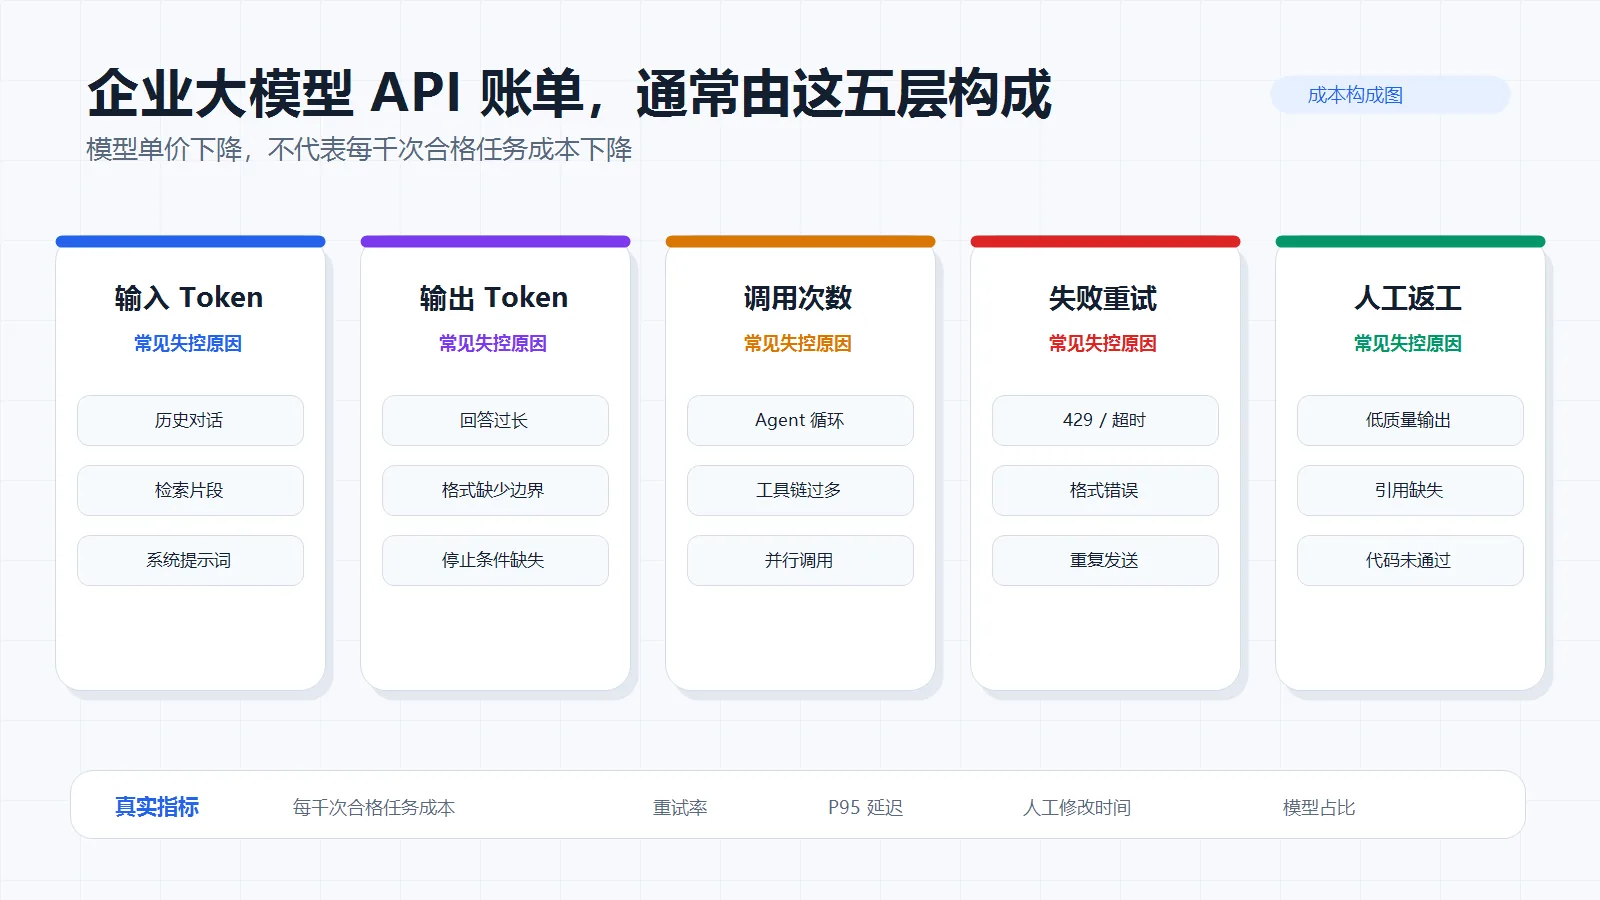
模型更强,为什么账单没有变轻
模型能力提升后,团队容易把更多工作交给 AI。客服开始保留完整历史对话,知识库把检索片段全部拼进提示词,代码 Agent 会连续调用搜索、执行和修复工具。每次调用的输入 Token 变长,调用次数也变多,单次价格下降不一定能抵消总用量增长。
还有一种常见误判:只看官方输入、输出 Token 价格,不看一次任务到底调用几轮。一次“生成周报”可能经过检索、摘要、改写、审核四个环节;一次代码修复可能循环十几次。真正需要统计的是每千次合格任务成本,包含失败重试、工具调用、人工修改和存储开销。
先把成本拆开,才知道哪里失控
企业做 API 成本优化,可以把账单拆成五层:输入 Token、输出 Token、模型调用次数、失败重试、人工返工。输入异常增长,通常和历史消息、检索片段或系统提示词过长有关;输出异常增长,常见原因是没有设置长度、格式和停止条件;调用次数失控,多半来自 Agent 没有步数上限。
日志至少要记录项目、用户、任务类型、模型 ID、输入输出 Token、延迟、状态码、重试次数和最终是否通过。把这些数据按业务场景分组,才能发现“低价模型跑了大量无效请求”或“高价模型解决了简单任务”这类问题。没有可观测性,换模型只是凭感觉,账单很快会回到原点。
省成本不等于全量换低价模型
低价模型适合分类、抽取、去重、标题生成、简单改写和高频客服;复杂代码、长文本研究、跨语言判断、复杂工具调用可以进入高阶模型池。企业应为每类任务设定主模型、升级条件和备用模型,依据输入长度、风险等级、质量分数、实时延迟和预算余额做路由。
DeepSeek API、Qwen API、GLM API、Kimi API、MiniMax 等国内大模型 API,可放入中文内容、境内知识库和本地采购场景的测试池。OpenAI API、Claude API、Gemini API 可用于代码、跨语言、长文本和多模态任务评估。模型价格、上下文限制、限流政策和可用地区会调整,具体配置以官方最新说明和实际控制台为准。
路由规则要有质量门槛。结构化结果先做 JSON 校验,知识库回答检查引用,代码任务运行测试用例;低置信度或格式失败再升级模型。两个模型并行生成再选优,适合少量高价值请求,不适合默认覆盖全量流量,否则 Token 账单会直接翻倍。
四个动作通常比换模型更有效
压缩上下文是最容易被忽略的一步。保留与当前问题相关的历史,长对话改为阶段摘要,检索结果做去重和截断,工具返回只保留后续步骤真正使用的字段。系统提示词也要分层,公共规则和任务规则不要在每个环节重复发送。
缓存适合稳定的系统提示词、重复检索结果、常见问答和批量任务。能使用供应商提示词缓存或平台缓存时,应观察命中率、有效期和隐私边界。批量生成、离线分类和夜间处理可以采用异步策略,减少高峰重试与超时带来的额外调用。
重试要有边界。429、超时和部分 5xx 可以指数退避,格式错误应先修正请求,业务校验失败要判断是否值得升级模型。每个 Agent 都要有最大步数、最大 Token、最大执行时间和预算阈值,达到条件就返回可解释的中间结果或交给人工。
评估指标也要从“回答看起来不错”改成“任务是否合格”。对比一次通过率、每千次合格任务成本、P95 延迟、重试率、人工修改时间和降级成功率,才能确认低价模型是否真的带来收益。
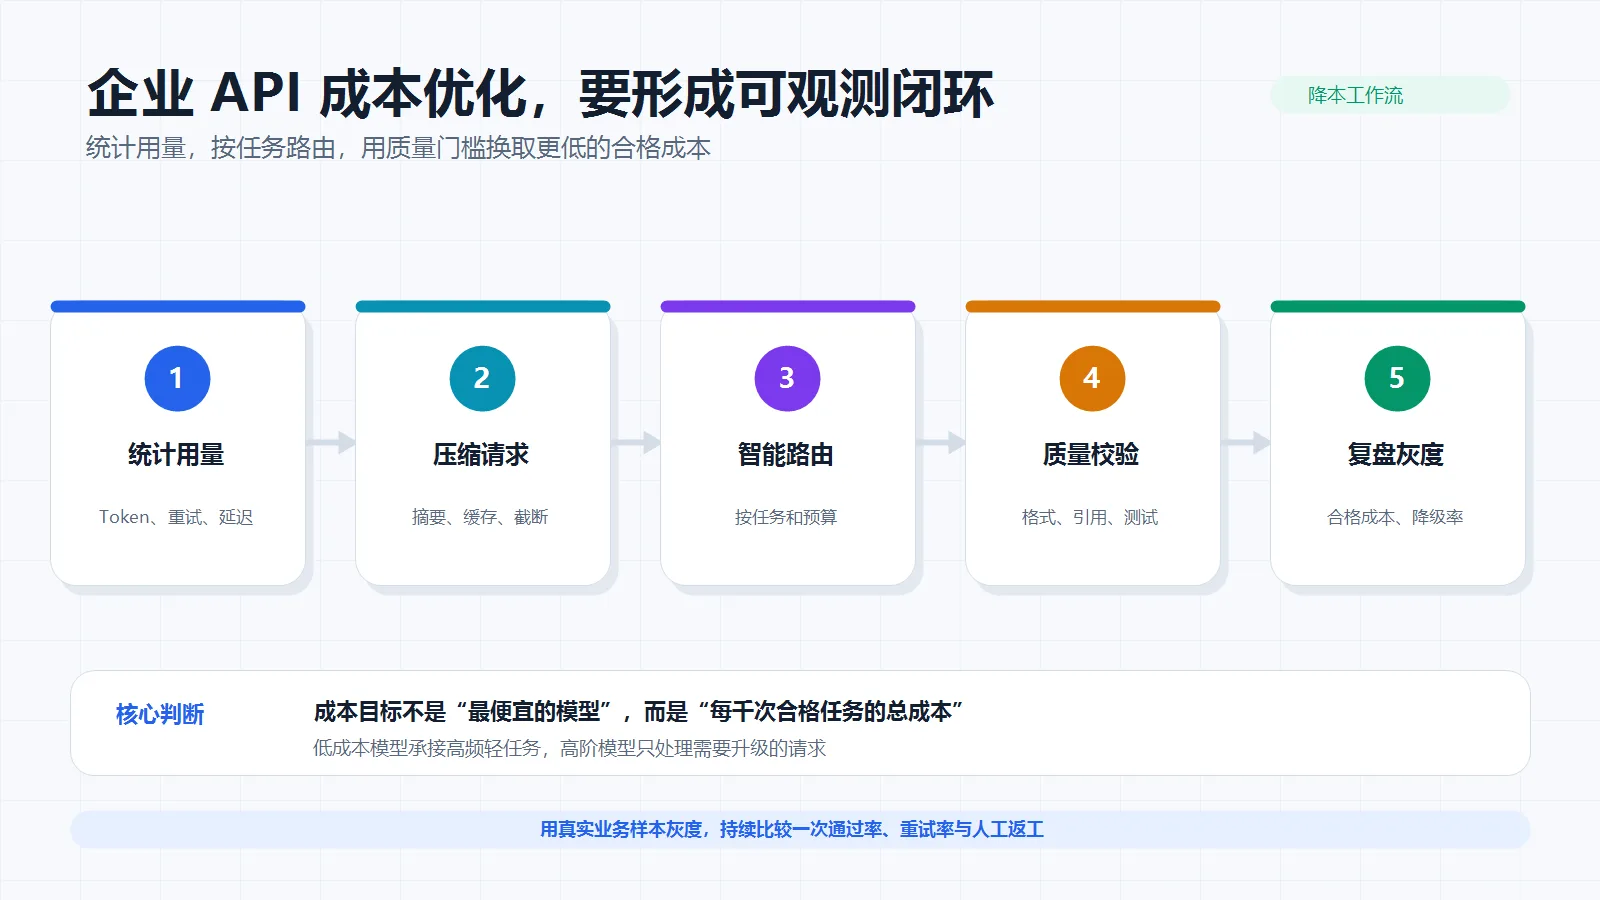
AI API 聚合平台能解决什么
AI API 聚合平台适合放在业务系统与模型供应商之间,统一处理鉴权、额度、预算、路由、限流、日志和故障切换。业务侧通过统一的企业 AI 接口调用多家模型,减少 OpenAI API、Claude API、Gemini API 和国内大模型 API 的多套适配工作。
平台不能替企业完成模型评测。选型时要确认真实模型 ID、版本追踪、分项目 Token、原始错误码、流式输出、工具调用、缓存能力和脱敏日志是否可用。像 Code0 这类 AI API 聚合平台,适合把多模型接入、模型选型和预算监控放到同一治理层。
一套可落地的降本顺序
先按任务建立七天用量基线,找出 Token、重试和高价模型占比最高的链路;再压缩提示词、设置输出上限和 Agent 步数;接着用真实样本测试低成本模型,设置质量门槛与升级规则;完成小流量灰度后,持续比较合格任务成本。
最新模型解决的是能力上限,API 成本能否下降,取决于调用策略、任务路由和运营数据。企业把每次请求当作可观测、可评估、可降级的生产任务,账单才会真正受到控制。